Урок 3: Верифікація та протидія маніпуляціям (текст / зображення / відео)
Попередній: Урок-02-GenAI-для-аналітика | Наступний: Урок-04-Соцмережі-та-медіапростір
Верифікація та протидія маніпуляціям
План заняття
| # | Блок | Інструмент / фокус | Час |
|---|---|---|---|
| 1 | Верифікація даних і трасування джерел у OSINT | концепції, чеклисти | 20 хв |
| 2 | Amsterdam Matrix (PDF handbook, 8 слайдів + воркшоп) | Amsterdam matrix OSINT Verification.pdf | 30 хв |
| 3 | MindsDB: Docker, таблиці, SQL, агенти, MCP; опційно Postgres Arkham | MindsDB Studio + Гайд-Docker-MindsDB-та-ArkhamMirror | 25 хв |
| 4 | Гість: Symphoria — інтелект і агентні розслідування | symphoria.ai | 10 хв |
| 5 | Масштаб проблеми та таксономія маніпуляцій | — | 10 хв |
| 6 | ArkhamMirror (SHATTERED): beta, архітектура, атлас шардів, запуск | frame + Docker / локально | 25 хв |
| 7 | Ingest, Claims, Contradictions, Media Forensics, Credibility, ACH | відповідні шарди | 30 хв |
| 8 | Повний workflow, інтеграції, експорт, підсумок, ДЗ | всі шарди + зовнішні інструменти | 40 хв |
Слайд 3 — Верифікація даних у OSINT: навіщо це «ядро» професії
Верифікація — це не «перечитати ще раз пост», а систематична перевірка, чи відповідає твердження доступним доказам, чи коректно зібраний ланцюжок від факту до висновку.
Чому без верифікації OSINT не існує як дисципліна:
- Швидкість поширення випереджає час на роздуми: перше враження часто закріплює хибну рамку.
- Синтетичний контент і реюз архівних матеріалів роблять «правдоподібність» дешевою — треба окремий шар технічної й логічної перевірки.
- Юридичні та репутаційні ризики: помилкове звинувачення або публічний факт без джерела можуть коштувати кар’єри й довіри до всього розслідування.
Практичний принцип уроку: жодного «сильного» висновку без відтворюваного шляху: які дані, з якого джерела, яким методом перевірені.
Трасування джерел (source tracing): основні поняття
Трасування джерела — відповідь на питання: звідки ця інформація потрапила до мене і чи я бачу той самий артефакт, що й первинне джерело?
| Поняття | Що означає в OSINT |
|---|---|
| Первинне джерело | Оригінал події / оригінальний файл / офіційний реліз без проміжних переказів |
| Вторинне джерело | Репортаж, тред, агрегатор, «згідно з…» — потребує звірки з первинкою |
| Провенанс (provenance) | Ланцюжок: хто, коли, де опублікував; які зміни/обрізки/скріни були між подією і твоїм архівом |
| Триангуляція | Незалежні лінії доказів (геолокація + час + метадані + незалежні медіа) мають сходитися |
| Атрибуція | Хто саме стоїть за акаунтом / сайтом / «витоком» — окремий рівень впевненості |
Помилка початківців: плутати «багато постів про те саме» з незалежними джерелами (часто це один первинний скрін, який перепощують).
Слайд 5 — Рівні верифікації: від «кліку» до звіту
- Рівень 0 — метадані та технічна автентичність: чи файл/відео/зображення узгоджуються з заявленим місцем і часом (EXIF, тіні, ELA, C2PA тощо) — не плутаємо з істиною змісту.
- Рівень 1 — змістова перевірка: чи твердження логічно випливає з цитат, таблиць, карт; чи немає підміни понять.
- Рівень 2 — міждокументна узгодженість: чи новий матеріал не суперечить уже перевіреним фактам (contradictions, timelines).
- Рівень 3 — гіпотези ACH (Analysis of Competing Hypotheses): кілька пояснень одних і тих самих спостережень + явні «дірки» в доказах.
Висновок: OSINT-продукт — це не скріншот, а документований стек рішень по цих рівнях.
Слайд 6 — Якість джерела vs якість аргументації
Навіть надійне джерело може містити слабкий аргумент; навпаки, стиль «нейтрального експерта» не замінює посилань на первинку.
Короткий чеклист аналітика:
- Є пряме посилання / ідентифікатор оригіналу (URL, архів, хеш файлу)?
- Дата публікації раніша за дату поширення вірусного твердження?
- Чи збігається мова тіла доказу з мовою переказу (немає «перекладних» викривлень)?
- Чи вказано межі невизначеності («невідомо», «ймовірно») там, де даних бракує?
Слайд 7 — Етика, безпека та межі верифікації
- Розділяй: «доказ технічної маніпуляції з файлом» і «доказ наміру конкретної особи» — це різні висновки.
- Документуй відмови: якщо первинку видалили — фіксуй Wayback / кеш / хеш до того, як слід зникне (де це дозволено).
Слайд 8 — Amsterdam Matrix: мета та область застосування
Що таке Amsterdam Matrix :
- Рамка для систематичної оцінки достовірності OSINT-матеріалів (оригінально — пости в Twitter/X; методологія переноситься на треди, Telegram-експорти, блоги, «розслідувальні» ).
- Мета — не «вподобайка», а прозора таблиця ознак, за якою двоє аналітиків можуть порівняти результати.
- Матриця допомагає відокремити силу доказової бази від харизми автора або кількості репостів.
Зв’язок зі слайдами 3–6: Matrix — це закріплений на папері спосіб пройти рівні верифікації та трасування джерел для одного артефакту (посту).
Слайд 9 — Amsterdam Matrix: шкала 1 / 0 / −1 і кольорова логіка
Згідно з handbook, кожен з 23 параметрів отримує код:
| Код | Зміст (узагальнено з PDF) |
|---|---|
| 1 | Ознака присутня і надійна / практика відповідає best practice |
| 0 | Невизначено, неповні дані, або неможливо перевірити з відкритих матеріалів |
| −1 | Ознака відсутня, слабка, або вказує на ризик маніпуляції / низьку якість |
Візуалізація в матеріалі PDF: «холодні» кольори для сильних сторін, «гарячі» — для ризиків, сірий — для прогалин. Це швидкий heatmap-профіль поста перед глибоким технічним аналізом.
Слайд 10 — Amsterdam Matrix: кластер Inclusion criteria
Питання кластера (логіка PDF): чи матеріал взагалі підпадає під осмислену OSINT-перевірку і чи додає він новий інсайт, а не лише емоцію.
Типові підкритерії (перевіряй по формулюваннях у PDF):
- чи є конкретне, фальсифіковане/підтверджуване твердження (а не загальна думка);
- чи автор додає оригінальні дані (координати, таблицю, файл), а не лише пересказ чужого скріну;
- чи не є пост чистим реагуванням без нового факту.
Практика: якщо тут переважно 0 / −1 — подальші 23 параметри часто не врятують слабкий матеріал; краще зупинитись і шукати первинку.
Слайд 11 — Amsterdam Matrix: Data / information / source integrity
Питання: чи прозорий ланцюжок джерела і чи немає прихованого шуму/підміни.
Що оцінюємо :
- наявність прямих посилань, архівів, згадок первинних медіа;
- авторство та анотації (хто зібрав, де знайдено файл);
- відсутність штучного шуму (зайві емодзі, «threadreader» без посилання на оригінал);
- ознаки маніпуляції даними (обрізаний скрін, переклад без оригіналу, «стислий» контекст).
Слайд 12 — Amsterdam Matrix: Argumentation quality
Питання: чи аргумент витримує перевірку логікою й методом.
Орієнтири з handbook:
- чи видно метод (як зібрано дані, які припущення);
- чи є реплікованість (інший аналітик може повторити кроки);
- чи автор чесно позначає невідоме замість заповнення прогалин здогадками;
- чи немає підміни кореляції на причинність.
Пам’ятай: сильна аргументація не компенсує фейкового первинного файлу — тому кластер Data / information / source integrity (слайд 11) залишається обов’язковим.
Слайд 13 — Amsterdam Matrix: Communication style + Community layer
Communication style (узагальнено):
- мінімум маніпулятивних прийомів (залякування, «us vs them» замість фактів);
- відсутність gaslighting аудиторії («всі брешуть, крім мене») без даних.
Community layer (узагальнено):
- коректне використання OSINT-термінів і інструментів (не «геолокація по тіні хмари» без пояснення);
- залучення репутаційних third parties (хто підтвердив, чи є peer review у спільноти);
- органічний engagement vs ознаки координованої накачки.
Ключовий висновок PDF (важливо для студентів): доброзичливий стиль не дорівнює правоті — вирішальним лишається поєднання integrity + argumentation.
Слайд 14 — MindsDB: що це, встановлення, роль у OSINT
MindsDB — це «AI-шар» над різними джерелами даних: ти підключаєш файли, API, бази, а далі працюєш єдиною мовою SQL + агентами, які відповідають природною мовою поверх таблиць.
Чому це важливо саме для OSINT-розслідувань:
- Таблична форма (час, джерело, сутність, статус перевірки, санкційний список тощо) — це мова, якою керівники й партнери найлегше порівнюють прогрес.
- Розмова з даними (AI Agent / chat over data) прискорює exploratory analysis: «які дати випадають?», «де дублікати?», «який топ джерел?» — за умови ручної перевірки висновків.
- Федерація: кілька таблиць / конекторів у одному запиті без написання окремого бекенду.
Як швидко підняти локально (Docker, Linux / macOS):
docker pull mindsdb/mindsdb
docker run -d --name mindsdb -p 47334:47334 mindsdb/mindsdb
Далі відкрий MindsDB Studio: http://127.0.0.1:47334. Детальніший сценарій разом із Arkham — у матеріалі курсу Гайд-Docker-MindsDB-та-ArkhamMirror.
Примітка: для агентів потрібен налаштований LLM (ключ або локальний endpoint) згідно документації MindsDB; у публічних скріншотах не показуй секрети.
Слайд 17 — Docker мережа: підключаємо MindsDB до Arkham PostgreSQL
Проблема за замовчуванням: mindsdb часто працює в bridge, а shattered-postgres — у shattered-network.
Треба додати mindsdb у мережу ArkhamMirror.
# 1) Перевір контейнери
docker ps --format "table {{.Names}}\t{{.Networks}}"

# 2) Додай mindsdb у мережу ArkhamMirror
docker network connect shattered-network mindsdb

# 3) Перевір, що mindsdb бачить shattered-postgres:5432
docker exec mindsdb python -c "import socket; print(socket.gethostbyname('shattered-postgres')); s=socket.create_connection(('shattered-postgres',5432),timeout=5); print('ok'); s.close()"
# -> 172.20.x.x
# -> ok
MindsDB onboarding/Studio (локальний інстанс):
Слайд 18 — Підключення Arkham DB всередині MindsDB
MindsDB UI: http://localhost:47334
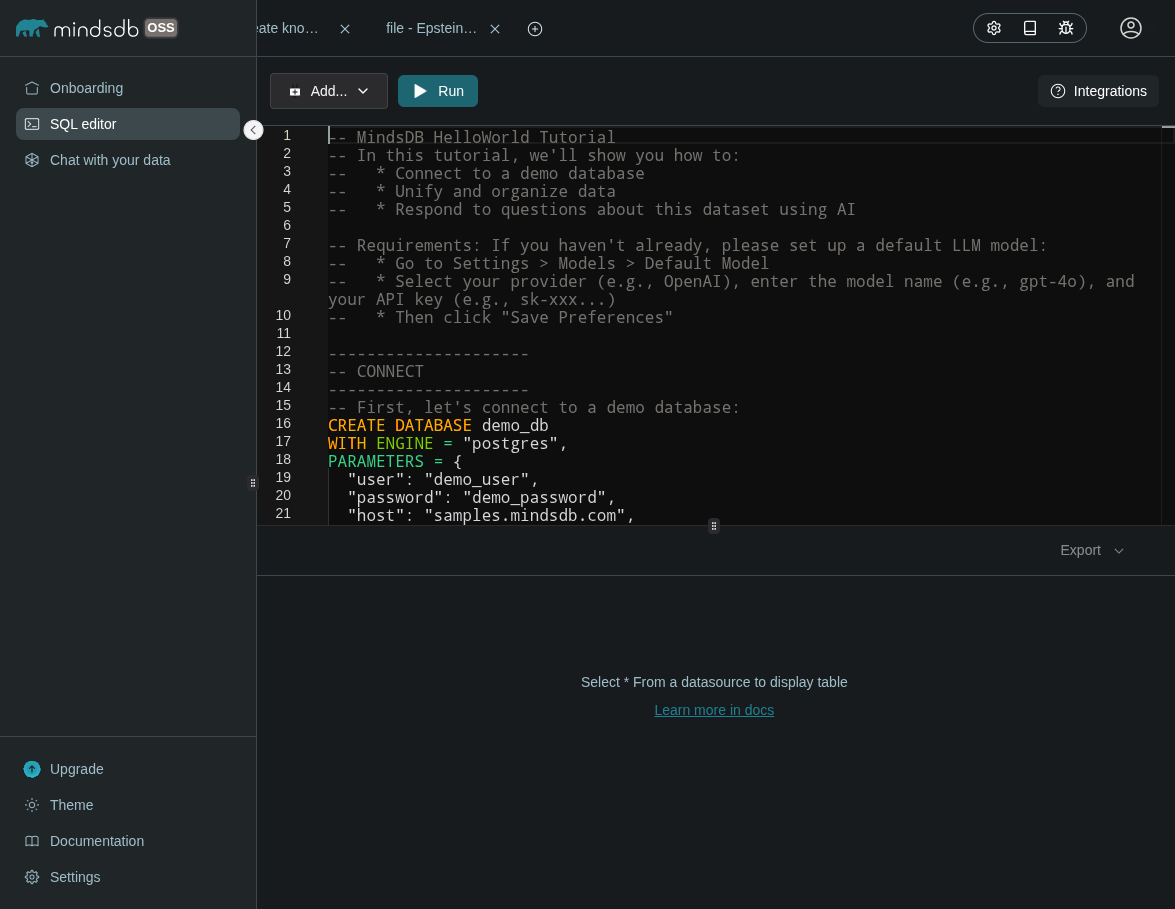
SQL Editor: виконай:
CREATE DATABASE arkham_pg
WITH ENGINE = 'postgres',
PARAMETERS = {
  "host": "shattered-postgres",
  "port": 5432,
  "user": "arkham",
  "password": "arkhampass",
  "database": "arkhamdb"
};

SHOW DATABASES;
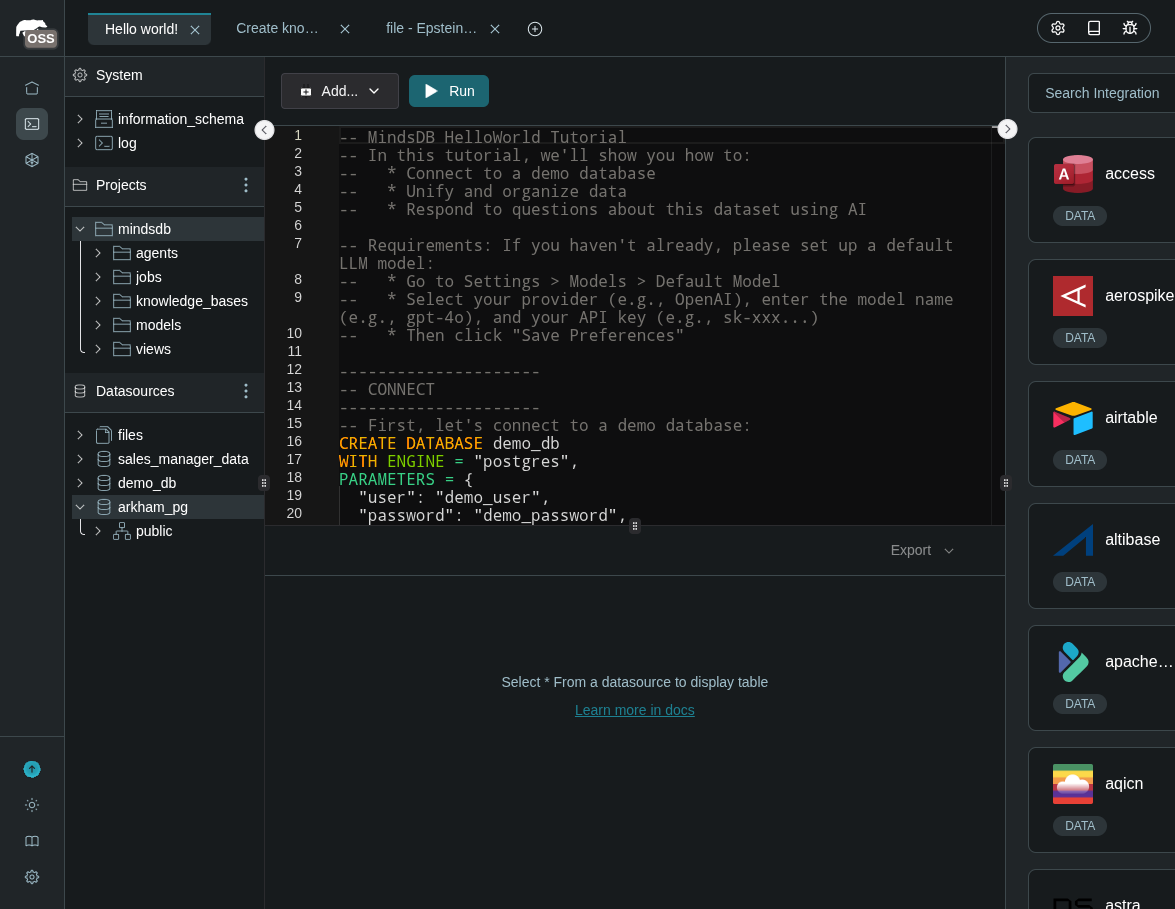
Очікувано в списку буде arkham_pg.
MindsDB SQL Editor (робоче середовище):
Слайд 19 — MindsDB: таблиці, SQL і «розмова» з доказовою базою
Типовий OSINT-пайплайн у MindsDB:
- Ingest / upload дозволеного датасету (наприклад, відкриті санкційні списки, агрегований таймлайн подій, експорт метаданих) у віртуальну базу MindsDB.
- SQL для контрольних зрізів: кількість записів за джерелом, вікно дат, статуси верифікації.
- Agent / chat для інтерпретації та гіпотез — завжди з повторною перевіркою первинних документів у Arkham або в оригінальному джерелі.
Чому «просто Excel» недостатньо: MindsDB тримає живі конектори до БД (у т.ч. до PostgreSQL Arkham у лабораторних сценаріях) і дозволяє повторно виконувати ті самі запити, коли корпус оновився після нового ingest.
Слайд 20 — Реальні SQL приклади: MindsDB читає ArkhamMirror
-- 1) Статус ingestion jobs
SELECT status, COUNT(*) AS jobs
FROM arkham_pg.arkham_ingest.jobs
GROUP BY status
ORDER BY jobs DESC;

-- 2) Останні 5 ingest jobs
SELECT id, filename, status, created_at
FROM arkham_pg.arkham_ingest.jobs
ORDER BY created_at DESC
LIMIT 5;

-- 3) Документи по проєктах Arkham
SELECT
  p.name AS project_name,
  COUNT(d.id) AS docs,
  COALESCE(SUM(d.file_size), 0) AS total_bytes
FROM arkham_pg.arkham_frame.projects p
LEFT JOIN arkham_pg.arkham_frame.documents d ON d.project_id = p.id
GROUP BY p.name
ORDER BY docs DESC;
Що це дає аналітику OSINT:
- миттєво бачиш обсяг оброблених матеріалів;
- контролюєш ingest-потік без окремих скриптів;
- будуєш комбіновані зрізи (проєкт + документи + jobs) в одному SQL-запиті.
MindsDB integrations/data tree з підключеним arkham_pg:
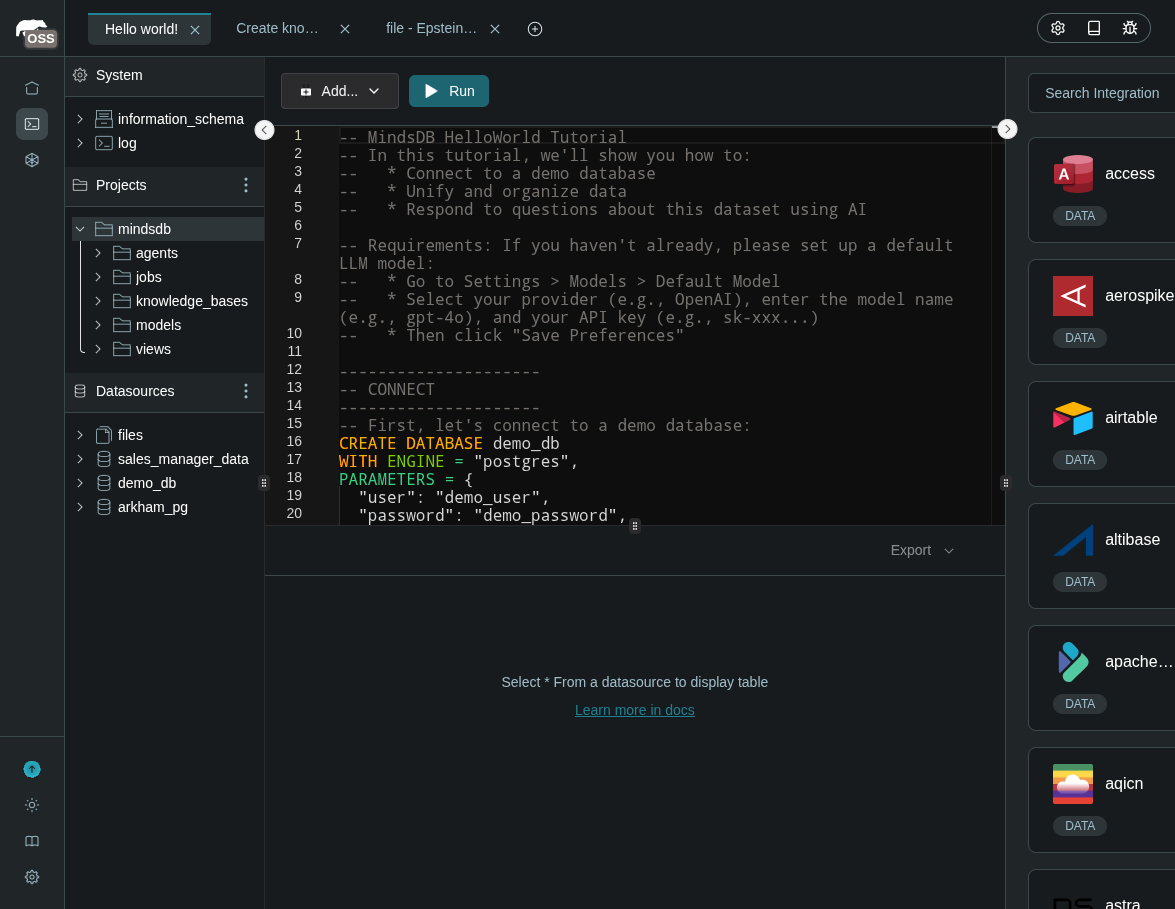
Arkham PostgreSQL datasource у MindsDB (вибраний і доступний):
Слайд 21 — Як використовувати MindsDB разом з Arkham у практиці
Робочий шаблон:
- ArkhamMirror: ingest/parse/entities/claims/contradictions.
- MindsDB: SQL-зрізи по
arkham_pg.*для моніторингу та аналітики. - Повернення результатів у звіт:
export/reportsв Arkham.
Приклад навчального кейсу:
- Arkham завантажує 3 кейси Italy;
- MindsDB рахує статуси jobs і розподіл документів по проєкту;
- аналітик додає ці метрики у фінальний verification report.
Слайд 22 — MindsDB як MCP-сервер для зовнішніх агентів
Model Context Protocol (MCP) — відкритий стандарт, яким користуються IDE та автономні агенти, щоб безпечно викликати інструменти (tools) замість «галюцинованого SQL».
Роль MindsDB у цій схемі: MindsDB може виступати MCP-сервером, через який зовнішній агент (Claude Desktop, Cursor, кастомний оркестратор) отримує можливість:
- перелічити підключені бази / джерела;
- виконувати federated query поверх уже налаштованих інтеграцій;
- повертати результати в структурованому вигляді для наступних кроків розслідування.
Офіційна документація (оновлюється разом із релізами): Model Context Protocol (MCP) — MindsDB та розділ Usage в тій самій документації.
Практичний сенс для курсу: ArkhamMirror залишається канонічним місцем для документів і верифікаційних шардів, MindsDB — SQL + MCP-шлюз, через який інші AI-агенти можуть читати табличні зрізи стану розслідування, не переписуючи інтеграції під кожен інструмент.
Слайд 24 — Масштаб проблеми (2024–2025)
| Показник | Цифра |
|---|---|
| Deepfake-інциденти Q1 2025 | 179000 — більше ніж за весь 2024 рік |
| Очікувані збитки від deepfake до 2027 | $40 млрд |
| Ріст AI-дезінформаційних кампаній | +300% за 2024 рік |
| Відсоток людей що правильно розпізнають deepfake | < 24% без тренування |
| Збитки від voice cloning (США, 2024) | $25+ млн |
| Час від фейку до вірусного поширення | < 6 годин |
Слайд 25 — Три типи маніпуляцій
| Тип | Визначення | Умисел | Для OSINT |
|---|---|---|---|
| Misinformation | Хибна інформація без злого умислу | Немає | Поширюється добросовісно |
| Disinformation | Навмисно створена хибна інформація | Є | Скоординована операція |
| Malinformation | Справжня інформація вжита для шкоди | Є | Найнебезпечніша — детектори не спрацюють |
Malinformation в практиці:
- Реальна фотографія катастрофи + неправильне місце і дата
- Справжній документ вирваний з контексту
- Реальна цитата без першоджерела та навколишнього контексту
Слайд 23 — Гість лекції: Alisher from Symphoria
Компанія: Symphoria — «Intelligence without compromise»: платформа для контекстного інтелекту та агентних розслідувань у правовому та корпоративному середовищі.
Що варто винести в контекст нашого курсу:
- Black Swan Data — рідкі, високовпливові сигнали в шумі (видалені сторінки, розбіжності між юрисдикціями, неочевидні зв’язки).
- Multi-dimensional contradiction — суперечності не лише логічні, а й часові, юрисдикційні, федеративні (людина vs AI-артефакти).
- Криптографічний провенанс — прив’язка знімка джерела до часу та хеша змісту (коли оригінал зникає або змінюється).
- Case Manager агенти — гіпотези, пошук по базах і вебу, візуалізація вузлів і зв’язків; Hypothesis Modeling — перехід від перевірених даних до захищеної наративної моделі для суду / регулятора / ради директорів.
Слайд 26 — SHATTERED (ArkhamMirror): статус проєкту та ідея
Важливо про зрілість: ArkhamMirror / SHATTERED — дуже свіжий open-source проєкт, фактично рання beta: змінюються ендпоінти, назви полів, поведінка воркерів і UI. Для курсу це плюс: ми дивимося на архітектурні ідеї, які рідко зібрані в одному місці, а не на «заморожений enterprise-продукт».
Що саме варто винести навіть попри beta:
- Voltron-модель: ядро (ArkhamFrame) + підключаючі шарди — кожен модуль ізольований, залежить лише від ядра.
- Подієва бус (EventBus): шарди не імпортують один одного напряму — з’єднання через події → менше крихких залежностей.
- Єдиний корпус даних: PostgreSQL + pgvector + черги jobs — зручно для трасування (що коли обробили) і для зовнішньої аналітики (наприклад, MindsDB поверх тих самих таблиць).
Архітектура (спрощено):
┌─────────────────────────────────────────┐
│           ArkhamFrame (ядро)            │
│  PostgreSQL · pgvector · EventBus       │
└────────────────┬────────────────────────┘
                 │
    ┌────────────┼────────────┐
    ▼            ▼            ▼
 [шарди: claims, media-forensics, ach, …]   ← повний перелік: слайди 28–29 (атлас шардів, дві частини)
                 │
    ┌────────────┼────────────┐
    ▼            ▼            ▼
  React UI   REST API   EventBus
  :8100      /docs      pub/sub
Слайд 27 — Архітектурні концепти ArkhamMirror (що «означає» дизайн)
| Концепт | Що це дає OSINT-команді | |
|---|---|---|
| Frame = незмінне ядро | Стабільні сервіси БД, векторів, LLM, воркерів; шарди не «ломають» платформу випадковими патчами. | |
| Shard = функціональний модуль | Можна ввімкнути/вивчити лише потрібне для кейсу (наприклад, спочатку ingest + claims). | |
| REST-first | Будь-який зовнішній скрипт, Jupyter, MindsDB може керувати розслідуванням без кліку по UI. | |
| Job queue | Важкі кроки (OCR, embed, парсинг) — асинхронно; аналітик бачить стан обробки, а не «зависання». | |
Проєкти (projects) | Ізоляція корпусів доказів між кейсами — критично для керованості та експорту. |
Слайд 27 — Атлас шардів ArkhamMirror: що робить кожен модуль (1/2)
Назви як у репозиторії; кількість модулів може бути 25–26 залежно від збірки.
| Шард | Що означає | Що робить у розслідуванні |
|---|---|---|
| dashboard | Системна «панель пульсу» | Статус сервісів, воркерів, подій — чи платформа готова приймати докази. |
| settings | Конфігурація | LLM, ключі зовнішніх API, параметри безпеки — без цього не працює автоматичний аналіз. |
| ingest | Прийом файлів | Черга завантажень: PDF, зображення, архіви → маршрутизація по воркерах. |
| documents | Каталог матеріалів | Перегляд, метадані, прив’язка до проєкту — «сейф-рум» сирого корпусу. |
| parse | Структурний розбір | Текст із PDF/DOCX/HTML для подальших NLP-кроків. |
| embed | Векторизація | Занурення фрагментів у pgvector для семантичного пошуку та кластеризації. |
| search | Пошук | Семантика / keyword / hybrid — знаходити згадки та схожі уривки в корпусі. |
| ocr | Розпізнавання тексту з зображень | Події на скрінах, фото документів, субтитри до кадрів відео-експортів. |
Слайд 28 — Amsterdam Matrix × ArkhamMirror (операціоналізація)
Як перенести Matrix у наш Arkham pipeline:
| Amsterdam Matrix блок | Де в ArkhamMirror |
|---|---|
| Джерела/кредити/анотації | Documents, Media Forensics, metadata в claims |
| Логічність і прозорість методу | Claims notes + Provenance chain |
| Реплікованість | ACH evidence + Provenance + Export |
| Маніпуляції/AI-content/noise | Media Forensics (EXIF/ELA/C2PA) + ручний review |
| Community signals | зовнішня перевірка + Credibility оцінки |
Слайд 29 — Атлас шардів ArkhamMirror: що робить кожен модуль (2/2)
| Шард | Що означає | Що робить у розслідуванні |
|---|---|---|
| claims | Фактичні твердження | Витягує перевірювані statements з тексту для подальшої верифікації. |
| contradictions | Суперечності | Шукає колізії між документами / твердженнями — сигнал для перегляду первинки. |
| credibility | Довіра до джерела | Скоринг, чеклисти (MOM/POP/MOSES/EVE), LLM-огляд — не плутаємо з істиною факту. |
| ach | Конкуруючі гіпотези | Матриця гіпотез ↔ доказів; змушує явно тримати кілька пояснень одних даних. |
| entities | Сутності | Особи, організації, локації — каркас для графа та таймлайну. |
| anomalies | Аномалії | Виявлення «дивних» патернів у метаданих або тексті — орієнтир для ручної перевірки. |
| patterns | Патерни | Повторювані структури в корпусі (мовні, часові) — допомагає побачити кампанії. |
| provenance | Провенанс | Ланцюжок походження артефактів і змін — ключовий для звіту й судової опори. |
| graph | Граф зв’язків | Візуалізація мережі сутностей і документів. |
| timeline | Хронологія | Відновлення послідовності подій — перевірка malinformation зі зміщеним часом. |
| export | Експорт «сирих» пакетів | Вивантаження структурованих даних для зовнішніх інструментів. |
| reports | Звіти | Формальні PDF/DOCX з висновками. |
| letters | Листи / шаблони комунікацій | Документування офіційних запитів (де релевантно). |
| packets | Пакети доказів | Збірки матеріалів для передачі юристам / партнерам. |
| templates | Шаблони | Стандартизація оформлення повторюваних кейсів. |
| summary | Резюме | Швидкий огляд великого корпусу перед глибоким читанням. |
| projects | Проєкти | Межі кейсу, доступ і організація всіх шардів навколо одного розслідування. |
Підказка викладача: не читай таблицю «з нуля» на лекції — покажи 3–4 релевантні рядки під конкретний кейс уроку, решта — для самостійного зазубрення.
Слайд 30 — SHATTERED: Запуск (Docker)
Найшвидший спосіб:
# 1. Перейди до директорії
cd /home/dresden/ArkhamMirror

# 2. Скопіюй конфіг
cp .env.example .env

# 3. Запусти все одною командою
docker compose up -d

# 4. Перевір що запустилось
curl http://localhost:8100/api/health
# → {"status": "ok", "shards": 26, ...}
Відкрий у браузері: http://localhost:8100
Перевір шарди:
curl http://localhost:8100/api/shards | jq '.[].name'
# → "media-forensics"
# → "claims"
# → "contradictions"
# → "credibility"
# → "ach"
# ... (26 шардів)
API документація: http://localhost:8100/docs
Слайд 32 — Перший крок: Проєкт і інгест документів
Крок 1 — Створи проєкт розслідування:
curl -X POST http://localhost:8100/api/projects \
  -H "Content-Type: application/json" \
  -d '{"name": "Верифікація: Херсон 2025-03"}'
# → {"id": "proj_abc123", "name": "Верифікація: Херсон 2025-03"}
Крок 2 — Завантаж документи:
# Один файл
curl -X POST http://localhost:8100/api/ingest/upload \
  -F "file=@report.pdf" \
  -F "priority=user"

# Або через UI:
# SHATTERED → Upload → перетягни файли
# → підтримує: PDF, DOCX, TXT, PNG, JPG, HTML, ZIP
Крок 3 — Перевір статус обробки:
curl http://localhost:8100/api/ingest/job/{job_id}
# → {"status": "completed", "route": ["cpu-parse", "cpu-ner", "gpu-embed"]}
Слайд 33 — Реальні скріншоти UI (після ingest)
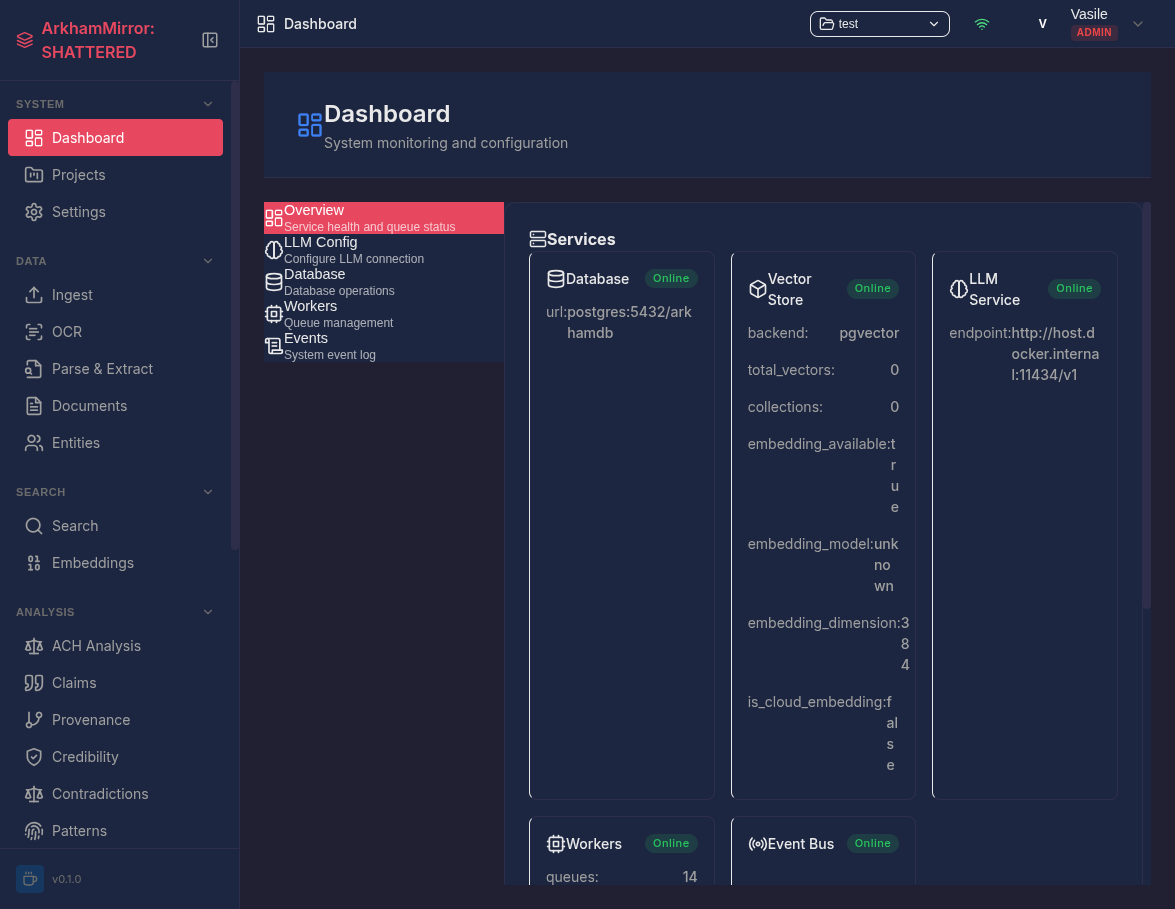
Dashboard після завантаження/інжесту даних:
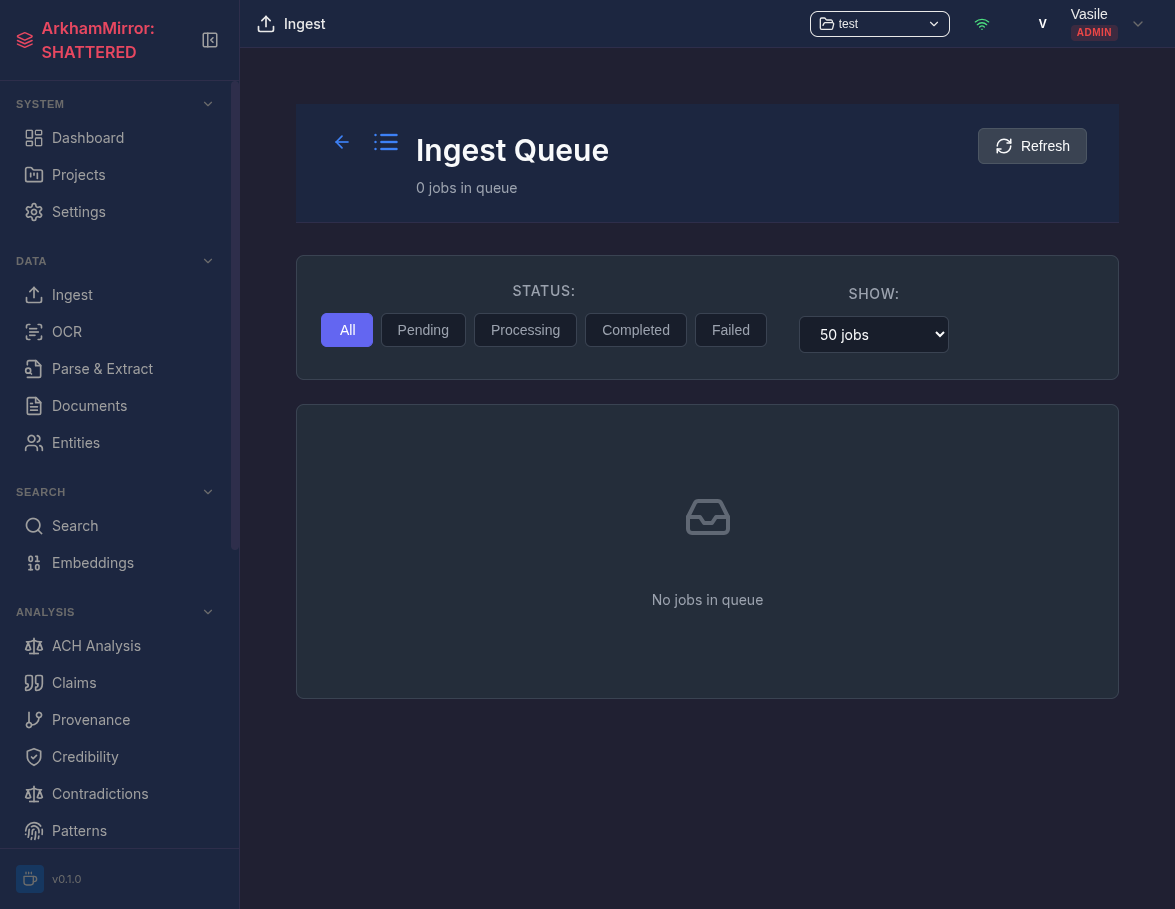
Ingest Queue після обробки batch (черга порожня):
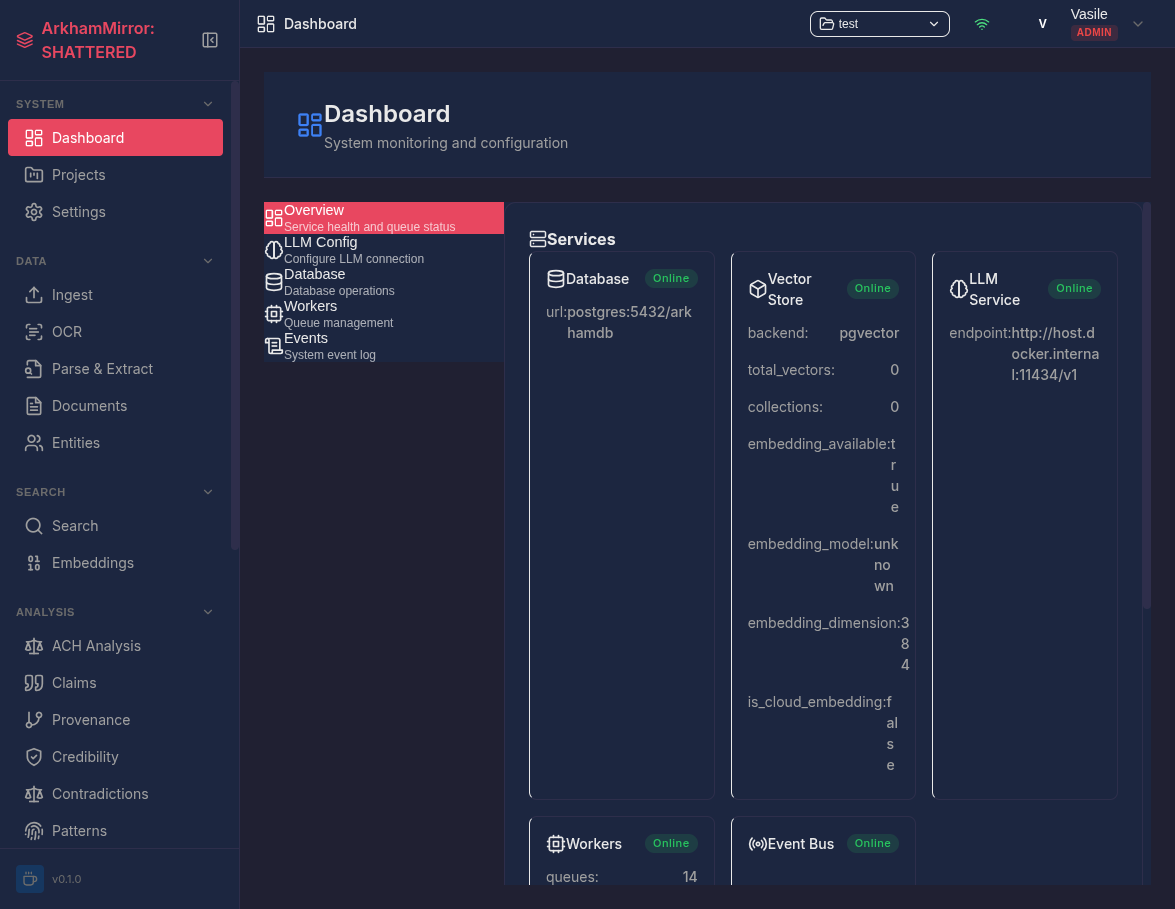
Arkham Dashboard (Overview):
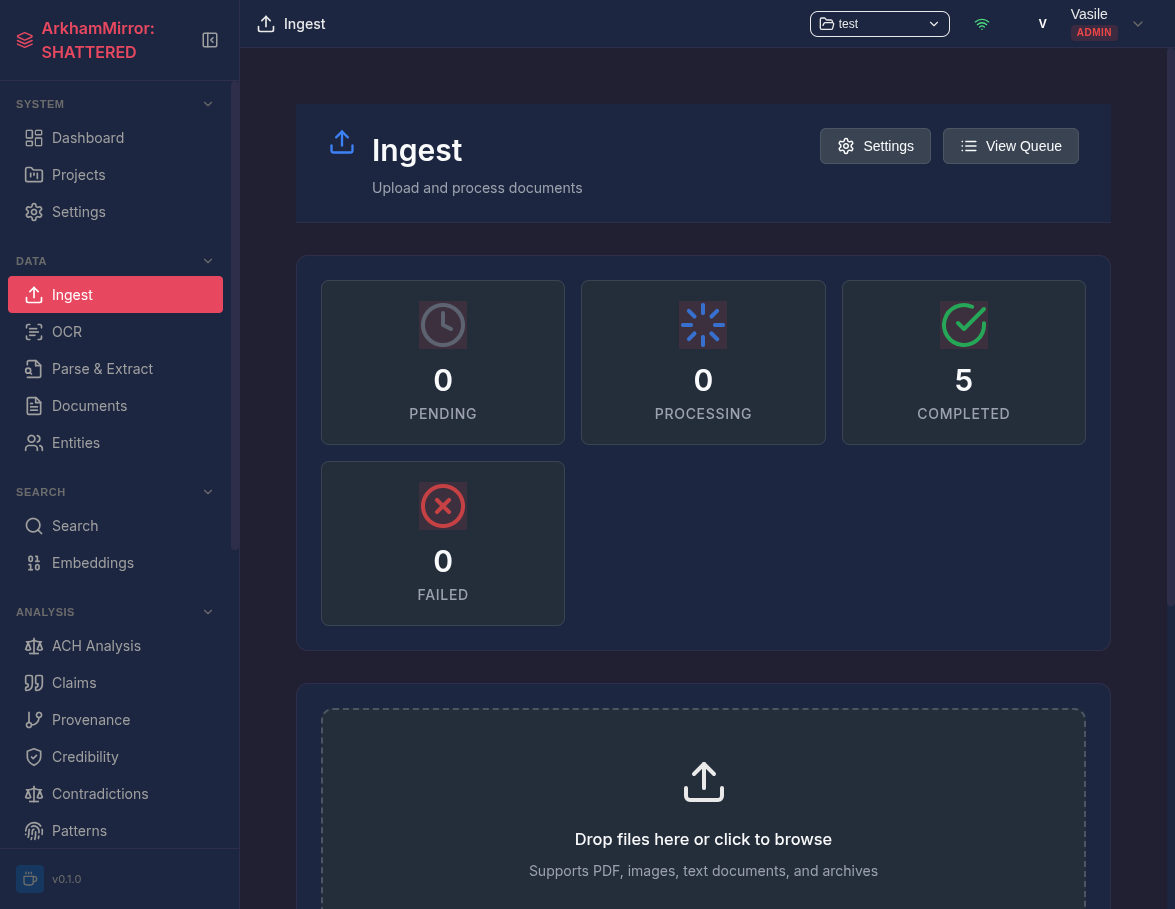
Arkham Ingest сторінка зі статистикою pipeline:
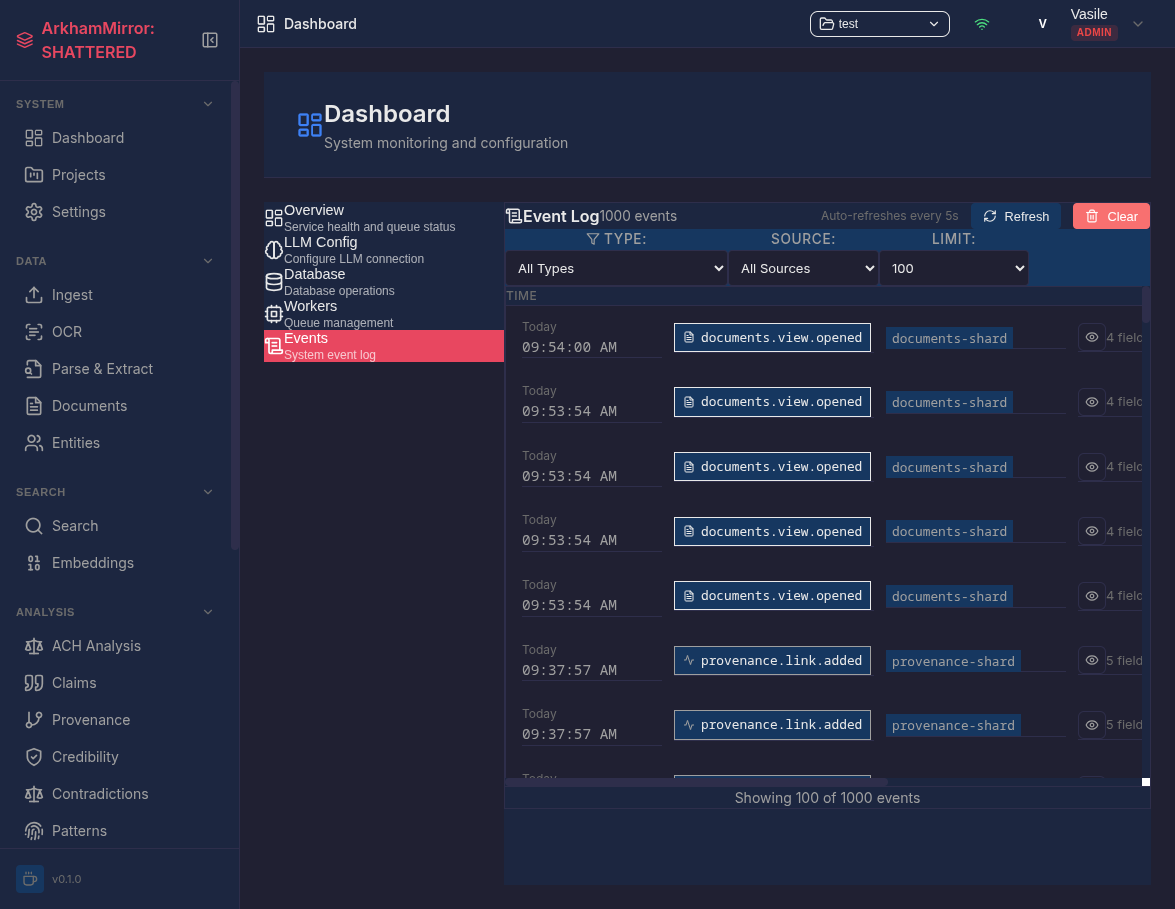
Arkham Event Log (живі події системи):
Слайд 34 — Шард Claims: Витяжка фактичних тверджень
Що робить: автоматично витягує фактичні твердження з тексту документів за допомогою LLM.
Типи тверджень:
| Тип | Опис |
|---|---|
factual | Верифіковані фактичні твердження |
opinion | Думки та суб’єктивні оцінки |
quote | Прямі цитати |
statistic | Статистичні твердження |
prediction | Прогнози та передбачення |
Статуси верифікації:
unverified → verified
          → disputed
          → false
          → retracted
Слайд 35 — Claims: Практична робота
1. Витягни твердження з тексту (API):
curl -X POST http://localhost:8100/api/claims/extract \
  -H "Content-Type: application/json" \
  -d '{
    "text": "Підрозділ ЗСУ \"Азов\" стратив 12 полонених у Херсоні 15 березня.
             Очевидці підтвердили інформацію. Відео з місця подій є у відкритому доступі.",
    "document_id": "doc_xyz"
  }'
Відповідь:
{
  "claims": [
    {
      "id": "claim_001",
      "text": "Підрозділ ЗСУ \"Азов\" стратив 12 полонених у Херсоні 15 березня",
      "type": "factual",
      "status": "unverified",
      "confidence": 0.91
    },
    {
      "id": "claim_002",
      "text": "Очевидці підтвердили інформацію",
      "type": "factual",
      "status": "unverified",
      "confidence": 0.78
    }
  ]
}
Слайд 36 — Claims: Додавання доказів
2. Прив’яжи докази до твердження:
curl -X POST http://localhost:8100/api/claims/{claim_id}/evidence \
  -H "Content-Type: application/json" \
  -d '{
    "evidence_type": "external",
    "reference_id": "https://tineye.com/search?...",
    "reference_title": "TinEye: відео знайдено 2019-07-22, джерело Reuters, Кабул",
    "relationship": "refutes",
    "strength": "strong",
    "excerpt": "First appearance: 2019-07-22, source domain: reuters.com"
  }'
Значення полів:
| Поле | Дозволені значення |
|---|---|
evidence_type | document, entity, external, claim |
relationship | supports, refutes, related |
strength | strong, moderate, weak |
3. Оновлення статусу твердження:
curl -X PATCH http://localhost:8100/api/claims/{claim_id}/status \
  -H "Content-Type: application/json" \
  -d '{
    "status": "disputed",
    "notes": "Відео архівне, Афганістан 2019, не Херсон"
  }'
Статуси: unverified → verified / disputed / retracted / uncertain
4. Витяжка з документа (замість тексту вручну):
# Якщо документ вже завантажений — SHATTERED сам читає вміст
curl -X POST http://localhost:8100/api/claims/extract-from-document/{document_id}
# → той самий ExtractionResponse, не потрібно копіювати текст
5. Переглянь всі твердження у UI:
SHATTERED → Claims → Фільтр: status: unverified → сортування за confidence desc
Слайд 37 — Шард Contradictions: Виявлення суперечностей
Що робить: порівнює документи між собою, знаходить суперечливі твердження через векторні ембедінги + LLM-верифікацію.
Типи суперечностей:
| Тип | Приклад |
|---|---|
direct | Документ А: “загинуло 5” / Документ Б: “загинуло 50” |
temporal | Різні дати однієї і тієї ж події |
quantitative | Числові розбіжності |
causal | Конфлікт причинно-наслідкових зв’язків |
attributive | ”Це сказав X” vs “це сказав Y” |
Severity рівні: critical → high → medium → low
Слайд 38 — Contradictions: Покрокова робота
Сценарій: ти отримав 3 різних звіти про одну подію. Перевіряємо чи вони узгоджені.
Крок 1 — Порівняй два документи:
curl -X POST http://localhost:8100/api/contradictions/analyze \
  -H "Content-Type: application/json" \
  -d '{
    "doc_a_id": "doc_report_A",
    "doc_b_id": "doc_report_B",
    "use_llm": true,
    "threshold": 0.75
  }'
Відповідь:
{
  "doc_a_id": "doc_report_A",
  "doc_b_id": "doc_report_B",
  "contradictions": [
    {
      "id": "cont_001",
      "type": "temporal",
      "severity": "high",
      "claim_a": "Подія відбулась о 14:00",
      "claim_b": "Подія відбулась о 09:00",
      "doc_a_id": "doc_report_A",
      "doc_b_id": "doc_report_B",
      "confidence": 0.87
    }
  ],
  "count": 1
}
Слайд 39 — Contradictions: Batch та Chain аналіз
Крок 2 — Batch аналіз кількох пар (3+ документи):
curl -X POST http://localhost:8100/api/contradictions/batch \
  -H "Content-Type: application/json" \
  -d '{
    "document_pairs": [
      ["doc_A", "doc_B"],
      ["doc_A", "doc_C"],
      ["doc_B", "doc_C"]
    ],
    "async_mode": false,
    "use_llm": true
  }'
Async режим для великих корпусів:
# async_mode: true → повертає job_ids замість результатів
# Статус перевіряється: GET /api/contradictions/jobs/{job_id}
Chain Detection — знаходить ланцюги суперечностей:
doc_A суперечить doc_B
doc_B суперечить doc_C
→ Chain: A → B → C (пов'язані суперечності)
→ Chain severity: critical
Крок 3 — Перегляд у UI:
SHATTERED → Contradictions → вибери матрицю → кольорове маркування:
- 🔴 Critical / 🟠 High / 🟡 Medium / 🟢 Low
Крок 4 — Зміна статусу:
# Підтвердити суперечність
curl -X PUT http://localhost:8100/api/contradictions/{cont_id}/status \
  -H "Content-Type: application/json" \
  -d '{"status": "confirmed", "notes": "Верифіковано через InVID"}'

# Відхилити (false positive)
curl -X PUT http://localhost:8100/api/contradictions/{cont_id}/status \
  -H "Content-Type: application/json" \
  -d '{"status": "dismissed", "notes": "Різні часові пояси — не суперечність"}'
Крок 5 — Автоматичне виявлення ланцюгів:
curl -X POST http://localhost:8100/api/contradictions/detect-chains \
  -H "Content-Type: application/json" \
  -d '{"min_chain_length": 2}'
# → знаходить A→B→C ланцюги між документами
Слайд 40 — Шард Media Forensics: Огляд
Для чого: аналіз автентичності зображень прямо у SHATTERED без зовнішніх інструментів.
Можливості:
| Функція | Що перевіряє |
|---|---|
| EXIF Extraction | Дата, GPS, модель камери, ПЗ |
| ELA Analysis | Error Level Analysis — виявлення монтажу |
| Perceptual Hashing | Пошук схожих зображень у базі |
| C2PA Verification* | Криптографічний підпис автентичності |
| Sun Position | Верифікація часу за положенням сонця |
| Reverse Image Search | Пошук в Google/TinEye/Yandex/Bing |
| *Coalition for Content Provenance and Authenticity (C2PA) |
Автоматичний тригер: при завантаженні будь-якого зображення media-forensics автоматично запускає аналіз через подію document.ingested.
Слайд 41 — Media Forensics: Запуск аналізу
Крок 1 — Завантаж зображення:
curl -X POST http://localhost:8100/api/ingest/upload \
  -F "file=@suspicious_photo.jpg"
# → {"job_id": "job_img_001", "document_id": "doc_img_001"}
Крок 2 — Запусти повний forensic аналіз:
curl -X POST http://localhost:8100/api/media-forensics/analyze \
  -H "Content-Type: application/json" \
  -d '{"document_id": "doc_img_001"}'
# → {"analysis_id": "analysis_001", "integrity_status": "flagged", "warnings": [...], ...}
Крок 3 — Отримай збережені результати:
# За analysis_id
curl http://localhost:8100/api/media-forensics/analyses/{analysis_id}

# За document_id (зручніше якщо не зберіг analysis_id)
curl http://localhost:8100/api/media-forensics/document/{document_id}
Batch аналіз кількох зображень:
curl -X POST http://localhost:8100/api/media-forensics/analyze/batch \
  -H "Content-Type: application/json" \
  -d '{"document_ids": ["doc_img_001", "doc_img_002", "doc_img_003"]}'
# → {"results": [...], "total": 3, "successful": 3, "failed": 0}
Або через UI:
SHATTERED → Documents → вибери зображення → вкладка “Media Forensics” → Run Analysis
Слайд 42 — Media Forensics: EXIF результати
Відповідь EXIF:
{
  "document_id": "doc_img_001",
  "metadata": {
    "DateTimeOriginal": "2019:07:22 14:32:11",
    "CreateDate": "2025:03:15 09:15:22",
    "GPSLatitude": 34.5553,
    "GPSLongitude": 69.2075,
    "GPSAltitude": 1791.0,
    "Make": "Apple",
    "Model": "iPhone 8",
    "Software": "Adobe Photoshop CC 2019",
    "ImageWidth": 4032,
    "ImageHeight": 3024
  },
  "flags": [
    {
      "type": "date_mismatch",
      "severity": "high",
      "detail": "CreateDate (2025) differs from DateTimeOriginal (2019) by 5+ years"
    },
    {
      "type": "edited_software",
      "severity": "medium",
      "detail": "Adobe Photoshop detected in Software field"
    },
    {
      "type": "gps_mismatch",
      "severity": "critical",
      "detail": "GPS coordinates point to Kabul, Afghanistan (34.5°N, 69.2°E), not Kherson"
    }
  ]
}
Слайд 43 — Media Forensics: Інтерпретація GPS
GPS 34.5553, 69.2075 → Кабул, Афганістан
Заявлено: Херсон, Україна
GPS з EXIF: Кабул, Афганістан (34.5°N, 69.2°E)

Херсон координати: ~46.6°N, 32.6°E
→ Різниця: 1350 км, інший континент
SHATTERED автоматично позначає:
gps_mismatch: critical— GPS не відповідає заявленому місцю- Надає посилання на Google Maps з координатами
- Зберігає у forensic звіті
Практично: якщо GPS є у метаданих → SHATTERED одразу перевіряє відповідність заявленому місцю. Без SHATTERED це треба робити вручну через ExifTool + Google Maps.
Слайд 44 — Media Forensics: ELA аналіз
Error Level Analysis через SHATTERED:
# Запусти ELA аналіз (потребує попереднього /analyze)
curl -X POST http://localhost:8100/api/media-forensics/ela \
  -H "Content-Type: application/json" \
  -d '{
    "analysis_id": "analysis_001",
    "quality": 95,
    "scale": 15
  }'
Параметри:
| Параметр | Значення | Значення |
|---|---|---|
quality | 70–100 (за замовч. 95) | Якість JPEG для ресейву |
scale | 5–30 (за замовч. 15) | Множник для візуалізації різниці |
Що повертається:
{
  "result": {
    "analysis_id": "analysis_001",
    "ela_image_base64": "iVBORw0KGgoAAAANS...",
    "global_avg_intensity": 12.4,
    "global_max_intensity": 87.3,
    "is_potentially_edited": true,
    "confidence": 0.71,
    "generated_at": "2025-03-15T10:22:00Z"
  }
}
Важливо:
- ELA повертає
ela_image_base64(не URL) — декодуй для відображення is_potentially_edited: trueякщо uniformity_score < 0.5 або std_error > 30- ELA не є остаточним доказом — завжди комбінуй з EXIF і reverse search
У UI: SHATTERED → Media Forensics → вибери аналіз → вкладка “ELA” → overlay (оригінал + ELA пліч-о-пліч)
Слайд 45 — Media Forensics: Перевірка C2PA
C2PA (Coalition for Content Provenance and Authenticity):
Криптографічний стандарт від Adobe, Microsoft, Intel, BBC, Reuters. Вбудовує підписаний сертифікат автентичності у файл.
C2PA в SHATTERED: автоматично перевіряється під час основного /analyze. Окремого ендпоінту немає.
# C2PA перевіряється автоматично при /analyze:
curl -X POST http://localhost:8100/api/media-forensics/analyze \
  -H "Content-Type: application/json" \
  -d '{"document_id": "doc_img_001"}'
Результат в полі c2pa аналізу:
{
  "analysis_id": "analysis_001",
  "c2pa": {
    "has_c2pa": true,
    "signer": "Reuters News Agency",
    "timestamp": "2025-03-15T14:32:11Z",
    "signature_valid": true,
    "assertions": ["c2pa.location.precise", "c2pa.actions"],
    "is_ai_generated": false
  },
  "integrity_status": "verified"
}
Якщо підпису немає:
{
  "c2pa": {"has_c2pa": false},
  "integrity_status": "unverified"
}
Перевірка підтримки C2PA бібліотеки:
curl http://localhost:8100/api/media-forensics/c2pa/supported
# → {"c2pa_available": true, "signature_verification_available": false}
# Підпис верифікується тільки якщо налаштовано MEDIA_FORENSICS_TRUST_ANCHORS_PATH
Offline-safe: SHATTERED перевіряє C2PA без мережевих запитів (requires trust anchors локально).
Слайд 46 — Media Forensics: Sun Position верифікація
Принцип: якщо є GPS і час — SHATTERED розраховує де має бути сонце і порівнює з тінями на фото.
Ендпоінт: частина повного аналізу. Також є окремий ендпоінт:
# Через analysis_id (після /analyze)
curl -X POST http://localhost:8100/api/media-forensics/sun-position \
  -H "Content-Type: application/json" \
  -d '{"analysis_id": "analysis_001"}'

# Або вручну з координатами і часом
curl -X POST http://localhost:8100/api/media-forensics/sun-position/manual \
  -H "Content-Type: application/json" \
  -d '{"latitude": 46.6354, "longitude": 32.6169, "datetime": "2025-03-15T14:30:00"}'
Результат:
{
  "claimed_datetime": "2025-03-15T14:30:00",
  "location": {"lat": 46.6354, "lng": 32.6169},
  "calculated_sun_azimuth": 220.5,
  "calculated_sun_elevation": 38.2,
  "expected_shadow_direction": "northeast",
  "assessment": "inconsistent",
  "detail": "Shadows in image point southeast, expected northeast at 14:30 local time. Estimated actual time: ~09:00"
}
Практичне значення: час зйомки не збігається з заявленим — фото або давніше, або зроблено в інший час.
Слайд 47 — Media Forensics: Reverse Image Search та Схожі зображення
Єдиний ендпоінт /similar — три режими роботи:
curl -X POST http://localhost:8100/api/media-forensics/similar \
  -H "Content-Type: application/json" \
  -d '{
    "analysis_id": "analysis_001",
    "hash_type": "phash",
    "threshold": 15,
    "search_type": "both",
    "limit": 50
  }'
Параметри:
| Параметр | Значення | Опис |
|---|---|---|
hash_type | phash, dhash, ahash | Тип хешу |
threshold | 0–64 (Hamming distance) | 0 = точний збіг, 15 = схоже |
search_type | internal, external, both | Де шукати |
Режим internal — шукає серед завантажених документів:
{
  "result": {
    "total_found": 1,
    "exact_matches": 0,
    "near_duplicates": 1,
    "similar_images": [
      {
        "filename": "kherson_report_feb.jpg",
        "similarity_score": 0.94,
        "similarity_type": "near_duplicate",
        "source": "internal"
      }
    ]
  }
}
Режим external — генерує URL для ручного пошуку (без API ключів):
{
  "result": {
    "search_urls": [
      {"engine": "Google Lens", "url": "https://lens.google.com/uploadbyurl?url=..."},
      {"engine": "TinEye",      "url": "https://tineye.com/search?url=..."},
      {"engine": "Yandex",      "url": "https://yandex.com/images/search?url=..."}
    ]
  }
}
Режим external з API ключами (TINEYE_API_KEY або SERPAPI_KEY у .env):
→ SHATTERED автоматично повертає результати замість URL
Слайд 48 — Media Forensics: AI Junior Analyst
Після forensic аналізу — AI узагальнює всі знахідки:
curl -X POST http://localhost:8100/api/media-forensics/ai/junior-analyst \
  -H "Content-Type: application/json" \
  -d '{
    "query": "What are the key authenticity concerns with this image?",
    "analysis_ids": ["analysis_001"],
    "project_id": "proj_abc"
  }'
Відповідь:
{
  "analysis": "The image presents multiple authenticity concerns...",
  "key_findings": [
    "GPS coordinates (Kabul, 34.5°N/69.2°E) contradict claimed Kherson location",
    "Date discrepancy: EXIF shows 2019, claimed 2025 — 6-year gap",
    "Adobe Photoshop detected in Software field",
    "ELA suggests potential composite editing in upper-left quadrant"
  ],
  "recommendation": "HIGH CONFIDENCE FAKE. Recommend dismissing this image as evidence.",
  "confidence": 0.91
}
Практичне застосування: після /analyze → /ela → /similar одним запитом отримуєш структурований висновок замість ручної інтерпретації 4 окремих результатів.
Слайд 49 — Шард Credibility: Система оцінки достовірності
Що робить: формалізована оцінка надійності джерел з трекінгом у часі.
Шкала:
| Рівень | Діапазон | Опис |
|---|---|---|
verified | 80–100 | Дуже надійне |
high | 60–79 | Зазвичай надійне |
medium | 40–59 | Помірно надійне |
low | 20–39 | Обмежена надійність |
unreliable | 0–19 | Не можна довіряти |
Типи джерел: document, entity (особа/організація), claim, external
Методи оцінки: manual, automated, llm, hybrid
Фактори: expertise, track_record, corroboration, recency, bias_indicators
Слайд 50 — Credibility: Практична оцінка
Крок 1 — Створи оцінку джерела:
curl -X POST http://localhost:8100/api/credibility/assessments \
  -H "Content-Type: application/json" \
  -d '{
    "source_id": "doc_telegram_post_001",
    "source_type": "document",
    "method": "manual",
    "factors": [
      {"name": "track_record", "score": 15, "weight": 2.0,
       "notes": "Канал зареєстрований 3 тижні тому"},
      {"name": "corroboration", "score": 5, "weight": 2.5,
       "notes": "Жодного незалежного підтвердження"},
      {"name": "bias_indicators", "score": 10, "weight": 1.5,
       "notes": "Лише проросійські наративи"}
    ],
    "notes": "Канал без верифікації, новий, антиукраїнський контент"
  }'
Відповідь:
{
  "score": 11.2,
  "level": "unreliable",
  "confidence": 0.85
}
Слайд 51 — Credibility: Deception Detection (MOM/POP/MOSES/EVE)
Інтелідженс-стандарт для детекції обману:
MOM — Motive, Opportunity, Means:
Motive: Чи є мотив для обману?
→ "Так: операція впливу для дискредитації ЗСУ"

Opportunity: Чи була можливість сфабрикувати?
→ "Так: deepfake генерація доступна"

Means: Чи є засоби для обману?
→ "Так: досвід у диспропаганді"
POP — Past Opposition Practices:
Чи використовувало це джерело раніше подібні техніки обману?
MOSES — Multiple, Orthogonal Sources:
Чи підтверджується інформація незалежними джерелами без спільного кореня?
EVE — Evaluation of Evidence:
Якість доказів: чи можна їх підробити? Чи вони специфічні? Чи перевіряються?
Слайд 52 — Credibility: LLM-аналіз через SHATTERED
LLM автоматично заповнює чеклисти MOM/POP/MOSES/EVE:
curl -X POST http://localhost:8100/api/credibility/assessments \
  -H "Content-Type: application/json" \
  -d '{
    "source_id": "doc_telegram_post_001",
    "source_type": "document",
    "method": "llm",
    "include_deception_checklist": true
  }'
Відповідь (вибрані поля):
{
  "score": 12,
  "level": "unreliable",
  "deception_analysis": {
    "checklist": "mom",
    "risk_level": "high",
    "items": [
      {
        "item": "motive",
        "present": true,
        "detail": "Channel has clear pro-Russia, anti-Ukraine bias in all posts"
      },
      {
        "item": "opportunity",
        "present": true,
        "detail": "Deepfake tools accessible; technical capability evident"
      },
      {
        "item": "means",
        "present": true,
        "detail": "Account behavior consistent with information operation"
      }
    ],
    "conclusion": "High deception risk. All MOM factors present."
  }
}
Слайд 53 — Credibility: Трекінг у часі
Зміна достовірності джерела у часі:
# Перегляд історії оцінок
curl http://localhost:8100/api/credibility/source/{source_id}/history

# → масив оцінок з датами
[
  {"date": "2025-01-15", "score": 45, "level": "medium"},
  {"date": "2025-02-20", "score": 28, "level": "low"},
  {"date": "2025-03-10", "score": 11, "level": "unreliable"}
]
Застосування в OSINT:
- Джерело яке деградує = активна пропаганда або захоплений акаунт
- Джерело яке стабільно середнє = незалежне але слабке
- SHATTERED зберігає повну аудит-трасу оцінок
У UI: SHATTERED → Credibility → вибери джерело → вкладка “History” → графік зміни
Слайд 54 — Шард ACH: Analysis of Competing Hypotheses
ACH — стандарт розвідувального аналізу (Richards J. Heuer Jr., CIA).
Ідея: замість доведення однієї гіпотези — систематично оцінювати всі можливі гіпотези проти кожного доказу.
Рейтинги відповідності:
| Рейтинг | Символ | Значення |
|---|---|---|
++ | Сильно підтверджує | Доказ сильно вказує на гіпотезу |
+ | Підтверджує | Доказ узгоджується з гіпотезою |
N | Нейтральний | Доказ не відноситься |
- | Суперечить | Доказ проти гіпотези |
-- | Сильно суперечить | Доказ різко суперечить |
NA | Не застосовно | Доказ нерелевантний |
Слайд 55 — ACH: Створення матриці верифікації
Сценарій: верифікуємо відео з Telegram — “Азов стратив полонених”
Гіпотези:
- H1: Відео справжнє і знято у Херсоні 2025
- H2: Відео архівне (інший конфлікт, інший рік)
- H3: Відео deepfake
- H4: Відео справжнє але неправильний контекст
ACH API — 4 окремих кроки (матриця → гіпотези → докази → рейтинги):
Крок 1 — Створи матрицю:
MATRIX=$(curl -s -X POST http://localhost:8100/api/ach/matrix \
  -H "Content-Type: application/json" \
  -d '{
    "title": "Верифікація: відео Telegram 2025-03-15",
    "description": "Чи є дане відео автентичним і чи відповідає заявленому контексту?"
  }' | jq -r '.matrix_id')

echo "Matrix: $MATRIX"
Крок 2 — Додай кожну гіпотезу окремо:
# H1
H1=$(curl -s -X POST http://localhost:8100/api/ach/hypothesis \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"title\": \"Відео справжнє, Херсон 2025\"}" | jq -r '.hypothesis_id')

# H2
H2=$(curl -s -X POST http://localhost:8100/api/ach/hypothesis \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"title\": \"Відео архівне (інший конфлікт)\"}" | jq -r '.hypothesis_id')

# H3
H3=$(curl -s -X POST http://localhost:8100/api/ach/hypothesis \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"title\": \"Відео deepfake\"}" | jq -r '.hypothesis_id')

# H4
H4=$(curl -s -X POST http://localhost:8100/api/ach/hypothesis \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"title\": \"Справжнє але хибний контекст\"}" | jq -r '.hypothesis_id')
Слайд 56 — ACH: Додавання доказів і рейтингів
Крок 3 — Додай докази (окремими запитами):
# Доказ 1: TinEye знайшов відео 2019 року
E1=$(curl -s -X POST http://localhost:8100/api/ach/evidence \
  -H "Content-Type: application/json" \
  -d "{
    \"matrix_id\": \"$MATRIX\",
    \"description\": \"TinEye: перша поява відео 2019-07-22, джерело Reuters, Кабул\",
    \"evidence_type\": \"fact\",
    \"source\": \"TinEye reverse image search\",
    \"credibility\": 0.9
  }" | jq -r '.evidence_id')

# Доказ 2: Мова у відео — арабська
E2=$(curl -s -X POST http://localhost:8100/api/ach/evidence \
  -H "Content-Type: application/json" \
  -d "{
    \"matrix_id\": \"$MATRIX\",
    \"description\": \"Аудіо аналіз: мова у відео арабська, не українська\",
    \"evidence_type\": \"fact\",
    \"credibility\": 0.85
  }" | jq -r '.evidence_id')
Крок 4 — Виставляй рейтинги (окремо для кожної пари доказ×гіпотеза):
# E1 vs H1: TinEye 2019 сильно суперечить "Херсон 2025"
curl -X PUT http://localhost:8100/api/ach/rating \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"evidence_id\": \"$E1\", \"hypothesis_id\": \"$H1\", \"rating\": \"--\"}"

# E1 vs H2: підтверджує "архівне відео"
curl -X PUT http://localhost:8100/api/ach/rating \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"evidence_id\": \"$E1\", \"hypothesis_id\": \"$H2\", \"rating\": \"++\"}"

# E1 vs H3: нейтральний для deepfake
curl -X PUT http://localhost:8100/api/ach/rating \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"evidence_id\": \"$E1\", \"hypothesis_id\": \"$H3\", \"rating\": \"N\"}"

# E2 vs H1: арабська мова суперечить Херсону
curl -X PUT http://localhost:8100/api/ach/rating \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"evidence_id\": \"$E2\", \"hypothesis_id\": \"$H1\", \"rating\": \"--\"}"
Рейтинги: ++ (сильно підтверджує) / + / N (нейтральний) / - / -- (сильно суперечить) / NA
Крок 5 — Розрахуй бали:
curl -X POST "http://localhost:8100/api/ach/score?matrix_id=$MATRIX"
# → scores з rank для кожної гіпотези
# Менший weighted_score = менш несумісна з доказами = більш ймовірна
Слайд 57 — ACH: AI-аналіз і Devil’s Advocate
AI Insights — узагальнює стан матриці:
curl -X POST http://localhost:8100/api/ach/ai/insights \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\"}"
Відповідь:
{
  "matrix_id": "matrix_001",
  "leading_hypothesis": "Відео архівне (інший конфлікт)",
  "key_evidence": [
    "TinEye дата 2019 — найбільш діагностичний доказ",
    "Арабська мова — виключає Херсон"
  ],
  "evidence_gaps": [
    "Необхідна геолокація архітектурних орієнтирів",
    "Перевірка оригінального Reuters репортажу"
  ],
  "cognitive_biases": [
    "Confirmation bias: відео поширюють ті хто вже не довіряє ЗСУ"
  ],
  "recommendations": ["Run perceptual hash search for 2019 Reuters archive"]
}
Devil’s Advocate — генерує найсильніші аргументи НА КОРИСТЬ вказаної гіпотези:
curl -X POST http://localhost:8100/api/ach/ai/devils-advocate \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"hypothesis_id\": \"$H1\"}"
# → challenge_text, weaknesses, evidence_gaps, recommended_investigations
# Навіть якщо H1 програє — змушує аналітика перевірити сліпі плями
AI генерація гіпотез і доказів (якщо хочеш автозаповнення):
# AI пропонує гіпотези на основі документів
curl -X POST http://localhost:8100/api/ach/ai/hypotheses \
  -d "{\"matrix_id\": \"$MATRIX\"}"

# AI пропонує докази з завантажених документів
curl -X POST http://localhost:8100/api/ach/ai/evidence \
  -d "{\"matrix_id\": \"$MATRIX\"}"

# AI виставляє рейтинги автоматично
curl -X POST http://localhost:8100/api/ach/ai/ratings \
  -d "{\"matrix_id\": \"$MATRIX\"}"
Слайд 58 — ACH: Premortem та Scenarios
Premortem аналіз:
“Уявімо що H2 виявилась ХИБНОЮ. Що ми не помітили?”
curl -X POST http://localhost:8100/api/ach/ai/premortem \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"hypothesis_id\": \"$H2\"}"
{
"premortem_id": "pre_001",
"hypothesis_title": "Відео архівне (інший конфлікт)",
"scenario_description": "We assumed archive footage but were wrong",
"overall_vulnerability": "medium",
"key_risks": ["TinEye index incomplete", "Metadata could be stripped/altered"],
"failure_modes": [
{
"failure_type": "evidence_gap",
"description": "TinEye database doesn't index all Reuters archive",
"likelihood": 0.15,
"early_warning_indicator": "Reuters denies owning that specific clip",
"mitigation_action": "Cross-check with AP Archive and Getty"
}
],
"recommendations": ["Verify with Reuters media desk directly"]
}Scenarios (Cone of Plausibility):
“Для кожної гіпотези — які спостережувані події підтвердять або спростують?”
curl -X POST http://localhost:8100/api/ach/ai/scenarios \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\"}"
# → список milestones/indicators для кожної гіпотези
# "Якщо H1 правда — ми побачимо незалежне підтвердження локації в 48г"
Слайд 59 — ACH: Корпусний пошук доказів
Corpus Search — SHATTERED шукає докази для ACH матриці прямо у завантажених документах:
curl -X POST http://localhost:8100/api/ach/ai/corpus-search \
  -H "Content-Type: application/json" \
  -d "{
    \"matrix_id\": \"$MATRIX\",
    \"query\": \"Kabul Afghanistan Reuters 2019\",
    \"limit\": 10
  }"
Результат: SHATTERED знаходить документи у проєкті що можуть слугувати доказами → пропонує їх додати до матриці.
Прийняти запропоновані докази:
curl -X POST http://localhost:8100/api/ach/ai/accept-corpus-evidence \
  -H "Content-Type: application/json" \
  -d "{
    \"matrix_id\": \"$MATRIX\",
    \"evidence_ids\": [\"suggested_ev_001\", \"suggested_ev_003\"]
  }"
Пошук по всьому корпусу (не один запит):
curl -X POST http://localhost:8100/api/ach/ai/corpus-search-all \
  -d "{\"matrix_id\": \"$MATRIX\"}"
# → шукає докази для ВСІХ гіпотез автоматично
Практичний workflow:
- Завантажив 50 документів у проєкт
- Створив матрицю + гіпотези
corpus-search-all→ SHATTERED знаходить релевантні докази серед 50 документів- Приймаєш відібрані, виставляєш рейтинги вручну або через
ai/ratings score+ai/insights→ висновок
Слайд 60 — ACH: Повна схема роботи з API
┌──────────────────────────────────────────────────────────────┐
│                    ACH Workflow (SHATTERED)                  │
├──────────────────────────────────────────────────────────────┤
│                                                              │
│  POST /api/ach/matrix                                        │
│  └── {"title": "...", "description": "..."}                  │
│      → matrix_id                                             │
│                                                              │
│  POST /api/ach/hypothesis  (×N разів)                        │
│  └── {"matrix_id": "...", "title": "H1: ..."}               │
│      → hypothesis_id (H1, H2, H3, ...)                       │
│                                                              │
│  POST /api/ach/evidence  (×M разів)                          │
│  └── {"matrix_id": "...", "description": "E1: ..."}         │
│      → evidence_id (E1, E2, ...)                             │
│                                                              │
│  PUT /api/ach/rating  (×N×M разів)                           │
│  └── {"matrix_id", "evidence_id", "hypothesis_id",          │
│       "rating": "++" | "+" | "N" | "-" | "--" | "NA"}       │
│                                                              │
│  POST /api/ach/score?matrix_id=...                           │
│  └── розраховує weighted inconsistency score                 │
│      → ranked hypotheses (менший score = більш ймовірна)    │
│                                                              │
│  POST /api/ach/ai/insights     → узагальнення               │
│  POST /api/ach/ai/premortem    → failure modes               │
│  POST /api/ach/ai/devils-advocate → blind spots              │
│  POST /api/ach/ai/corpus-search   → auto-find evidence      │
│                                                              │
│  GET  /api/ach/export/{matrix_id} → JSON звіт               │
└──────────────────────────────────────────────────────────────┘
Ключова відмінність від “старого” підходу:
- Матриця, гіпотези, докази і рейтинги — окремі ресурси (REST-CRUD)
- Порядок: спочатку матриця → потім гіпотези → потім докази → потім рейтинги
- AI функції — окремі ендпоінти, не вбудовані в CRUD
scoreрахується після виставлення рейтингів (не автоматично)
Слайд 61 — Summary шард: Швидке резюме для першого огляду
Перед глибоким аналізом: швидко зрозуміти про що документ без читання повністю.
Типи резюме:
| Тип | Опис | Коли використовувати |
|---|---|---|
brief | 1–2 речення | Перший огляд 50+ документів |
standard | Абзац | Стандартна робота |
key_points | Маркований список | Перед ACH |
executive | Для звіту | Для замовника |
detailed | Кілька абзаців | Ключовий документ |
curl -X POST http://localhost:8100/api/summary/ \
  -H "Content-Type: application/json" \
  -d '{
    "source_type": "document",
    "source_id": "doc_report_A",
    "summary_type": "key_points"
  }'
Автоматично при завантаженні: SHATTERED може налаштуватись на авто-резюме кожного нового документа.
Слайд 62 — Search шард: Пошук пов’язаних документів
Три режими пошуку для верифікації:
# Семантичний пошук (за змістом)
curl -X POST http://localhost:8100/api/search/ \
  -d '{
    "query": "Azov prisoners execution Kherson",
    "mode": "semantic",
    "project_id": "proj_abc"
  }'

# Keyword (точні слова)
curl -X POST http://localhost:8100/api/search/ \
  -d '{
    "query": "\"Азов\" \"страта\" \"полонені\"",
    "mode": "keyword"
  }'

# Hybrid (семантика 70% + keyword 30%)
curl -X POST http://localhost:8100/api/search/ \
  -d '{
    "query": "Azov execution footage Telegram",
    "mode": "hybrid",
    "semantic_weight": 0.7,
    "keyword_weight": 0.3
  }'
Пошук схожих документів:
curl -X POST /api/search/similar/{doc_id}
# → документи зі схожим змістом → можуть суперечити або підтверджувати
Слайд 63 — Повний верифікаційний workflow в SHATTERED
Кейс: Telegram-відео “Азов стратив 12 полонених”
КРОК 1 — ПРОЄКТ
  POST /api/projects
  → {"name": "Верифікація: Telegram 2025-03-15"}

КРОК 2 — ІНГЕСТ
  POST /api/ingest/upload (multipart)
  → завантажуємо відео кадр, скріншот поста, текстові матеріали

КРОК 3 — MEDIA FORENSICS (зображення)
  POST /api/media-forensics/analyze
  → body: {"document_id": "doc_img_001"}
  → автоматично: EXIF, perceptual hash, C2PA
  POST /api/media-forensics/ela → {"analysis_id": "..."}
  POST /api/media-forensics/similar → {"analysis_id": "...", "search_type": "both"}
  → результат: GPS = Кабул, дата = 2019, is_potentially_edited: true

КРОК 4 — CLAIMS (текст поста)
  POST /api/claims/extract-from-document/{doc_id}
  → 4 твердження витягнуто автоматично
  PATCH /api/claims/{id}/status → {"status": "disputed", "notes": "..."}

КРОК 5 — CONTRADICTIONS (Reuters архів vs Telegram пост)
  POST /api/contradictions/analyze
  → body: {"doc_a_id": "reuters_2019", "doc_b_id": "telegram_2025", "use_llm": true}
  → temporal contradiction: high

КРОК 6 — CREDIBILITY (Telegram канал)
  POST /api/credibility/assessments + "method": "llm", "include_deception_checklist": true
  → score: 11/100, level: unreliable, deception risk: high (MOM all present)

КРОК 7 — ACH (структурований висновок)
  POST /api/ach/matrix → create
  POST /api/ach/hypothesis (×4) → add each
  POST /api/ach/evidence (×N) → add each
  PUT  /api/ach/rating (×N×4) → set each
  POST /api/ach/score?matrix_id=... → calculate
  POST /api/ach/ai/insights → leading hypothesis: "Архівне відео, Кабул 2019"
  POST /api/ach/ai/premortem → failure modes
  POST /api/ach/ai/devils-advocate → blind spots check

КРОК 8 — EXPORT
  POST /api/export → {"project_id": "...", "format": "pdf"}
Слайд 64 — Workflow: Час на кожний крок
| Крок | Ручна робота | З SHATTERED |
|---|---|---|
| Зворотний пошук зображення | 5 хв (3 платформи) | 30 сек (автоматично при завантаженні) |
| EXIF аналіз | 3 хв (ExifTool + інтерпретація) | 15 сек (автоматичні flags) |
| GPS верифікація | 5 хв (вручну Google Maps) | Автоматично з alerts |
| ELA аналіз | 3 хв (FotoForensics) | 20 сек |
| Sun position | 5 хв (SunCalc вручну) | Автоматично |
| Claims extraction | 15 хв (ручне читання) | 2 хв (LLM) |
| Contradictions (3 документи) | 30 хв | 3 хв |
| Credibility + MOM | 20 хв | 5 хв (LLM) |
| ACH матриця (4 гіпотези) | 45 хв | 15 хв |
| РАЗОМ | ~2,5 години | ~26 хвилин |
Слайд 65 — Export і документування
SHATTERED Export шард:
# Повний звіт розслідування
curl -X POST http://localhost:8100/api/export \
  -d '{
    "project_id": "proj_abc",
    "format": "pdf",
    "include": ["summary", "claims", "contradictions", "credibility", "ach", "media_forensics"]
  }'

# Або JSON для подальшої обробки
curl -X POST http://localhost:8100/api/export \
  -d '{"project_id": "proj_abc", "format": "json"}'
Reports шард — структуровані аналітичні звіти:
curl -X POST http://localhost:8100/api/reports \
  -d '{
    "type": "investigation_summary",
    "project_id": "proj_abc",
    "title": "Верифікаційний звіт: Telegram відео 2025-03-15"
  }'
Packets — повний пакет з версіюванням:
# Зберегти весь стан розслідування для архіву або передачі
curl -X POST http://localhost:8100/api/packets \
  -d '{"project_id": "proj_abc", "include_documents": true}'
Слайд 66 — Практичний кейс: Покрокова сесія (частина 1)
Запускаємо SHATTERED і починаємо верифікацію
Стартова ситуація: отримали посилання на Telegram-канал з відео.
В терміналі:
# Перевіряємо що SHATTERED запущений
curl http://localhost:8100/api/health
# {"status": "ok", "shards": 26}

# Створюємо проєкт
PROJECT=$(curl -s -X POST http://localhost:8100/api/projects \
  -H "Content-Type: application/json" \
  -d '{"name": "VER-2025-047 Telegram відео"}' | jq -r '.id')

echo "Project ID: $PROJECT"
# Project ID: proj_abc123
Завантажуємо матеріали:
# Скріншот поста (текст для Claims)
JOB1=$(curl -s -X POST http://localhost:8100/api/ingest/upload \
  -F "file=@telegram_post.png" | jq -r '.job_id')

# Ключовий кадр відео (для Media Forensics)
JOB2=$(curl -s -X POST http://localhost:8100/api/ingest/upload \
  -F "file=@video_frame.jpg" | jq -r '.job_id')

echo "Jobs: $JOB1 / $JOB2"
Слайд 67 — Практичний кейс: Покрокова сесія (частина 2)
Очікуємо обробки і запускаємо Media Forensics + Claims:
# Чекаємо завершення
sleep 10
curl "http://localhost:8100/api/ingest/job/$JOB2" | jq '.status'
# "completed"

# Знаходимо document_id зображення
DOC_IMG=$(curl -s "http://localhost:8100/api/documents?project_id=$PROJECT" \
  | jq -r '.items[] | select(.filename | contains("video_frame")) | .id')

# Media Forensics: тіло запиту — document_id у JSON
ANALYSIS=$(curl -s -X POST http://localhost:8100/api/media-forensics/analyze \
  -H "Content-Type: application/json" \
  -d "{\"document_id\": \"$DOC_IMG\"}" | jq -r '.analysis_id')

sleep 5
# Перевіряємо результат
curl "http://localhost:8100/api/media-forensics/analyses/$ANALYSIS" \
  | jq '{integrity: .integrity_status, warnings: .warnings}'
Результат:
{
  "integrity": "flagged",
  "warnings": [
    "GPS coordinates (34.5°N, 69.2°E) point to Kabul, Afghanistan",
    "DateTimeOriginal 2019 differs from CreateDate 2025 by 6 years",
    "Adobe Photoshop detected in Software EXIF field"
  ]
}
Паралельно — витягуємо Claims з тексту поста:
DOC_POST=$(curl -s "http://localhost:8100/api/documents?project_id=$PROJECT" \
  | jq -r '.items[] | select(.filename | contains("telegram_post")) | .id')

# Витяжка з документа (без копіювання тексту вручну)
curl -X POST "http://localhost:8100/api/claims/extract-from-document/$DOC_POST" \
  | jq '.claims[] | {text: .text, type: .type, confidence: .confidence}'
Слайд 68 — Практичний кейс: Покрокова сесія (частина 3)
ACH матриця і фінальний висновок:
# Крок 1: Матриця
MATRIX=$(curl -s -X POST http://localhost:8100/api/ach/matrix \
  -H "Content-Type: application/json" \
  -d '{"title": "VER-2025-047", "description": "Верифікація Telegram відео"}' \
  | jq -r '.matrix_id')

# Крок 2: Гіпотези
H1=$(curl -s -X POST http://localhost:8100/api/ach/hypothesis \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"title\": \"Відео автентичне, Херсон 2025\"}" \
  | jq -r '.hypothesis_id')
H2=$(curl -s -X POST http://localhost:8100/api/ach/hypothesis \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"title\": \"Відео архівне, інший конфлікт\"}" \
  | jq -r '.hypothesis_id')

# Крок 3: Доказ (GPS + дата з Media Forensics)
E1=$(curl -s -X POST http://localhost:8100/api/ach/evidence \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"description\": \"EXIF GPS: Кабул 34.5N/69.2E, дата 2019\", \"evidence_type\": \"fact\", \"credibility\": 0.95}" \
  | jq -r '.evidence_id')

# Крок 4: Рейтинги
curl -s -X PUT http://localhost:8100/api/ach/rating \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"evidence_id\": \"$E1\", \"hypothesis_id\": \"$H1\", \"rating\": \"--\"}"
curl -s -X PUT http://localhost:8100/api/ach/rating \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\", \"evidence_id\": \"$E1\", \"hypothesis_id\": \"$H2\", \"rating\": \"++\"}"

# Крок 5: Score + AI insights
curl -s -X POST "http://localhost:8100/api/ach/score?matrix_id=$MATRIX" | jq '.scores[].rank'
curl -s -X POST http://localhost:8100/api/ach/ai/insights \
  -H "Content-Type: application/json" \
  -d "{\"matrix_id\": \"$MATRIX\"}" | jq '{leading: .leading_hypothesis, gaps: .evidence_gaps}'
Результат → Оцінка D (не підтверджено):
{"leading": "Відео архівне, інший конфлікт", "gaps": ["GPS needs independent geolocation confirmation"]}Слайд 69 — Конфігурація SHATTERED для верифікації
Оптимальний .env для верифікаційного workflow:
# .env
DATABASE_URL=postgresql://arkham:password@localhost:5432/shattered

# LLM для claims, credibility, contradictions, ACH
LLM_ENDPOINT=http://localhost:1234/v1   # LM Studio + Llama 3.1 8B
# або
LLM_ENDPOINT=https://api.openai.com/v1
LLM_API_KEY=sk-your-key

# Vision LLM для аналізу зображень
VLM_ENDPOINT=http://localhost:1234/v1   # LM Studio + Qwen-VL
# або
VLM_ENDPOINT=https://api.openai.com/v1  # GPT-4o
VLM_API_KEY=sk-your-key

# Reverse image search (необов'язково)
SERPAPI_KEY=your-key                    # 100 пошуків/місяць безкоштовно
TINEYE_API_KEY=your-key                 # платний
GOOGLE_VISION_API_KEY=your-key          # безкоштовний tier

# Продуктивність
AUTH_SECRET_KEY=generate-random-key
ARKHAM_OFFLINE_MODE=false
Слайд 70 — Worker пули для верифікації
Запуск необхідних воркерів:
# Мінімальний набір для верифікації (без GPU)
python -m arkham_frame.workers.cli --pool cpu-light --count 4
python -m arkham_frame.workers.cli --pool cpu-ner --count 2
python -m arkham_frame.workers.cli --pool cpu-image --count 2
python -m arkham_frame.workers.cli --pool llm-enrich --count 2
python -m arkham_frame.workers.cli --pool llm-analysis --count 1

# З GPU (OCR через PaddleOCR + кращі ембедінги)
python -m arkham_frame.workers.cli --tier recommended
# запускає: gpu-paddle (OCR), gpu-embed (ембедінги), + всі CPU пули

# Перегляд доступних пулів і тирів
python -m arkham_frame.workers.cli --list-pools
python -m arkham_frame.workers.cli --list-tiers
Управління через Dashboard (без термінала):
SHATTERED → Dashboard → вкладка “Workers” → кнопки Scale / Start / Stop
Перегляд черги:
curl http://localhost:8100/api/ingest/queue
# {"pending": 3, "processing": 1, "completed": 47, "failed": 0}

# Retry failed jobs
curl -X POST http://localhost:8100/api/ingest/queue/retry-failed
Слайд 71 — SHATTERED: UI навігація для верифікації
Основні екрани (http://localhost:8100):
SHATTERED UI
├── Dashboard          → загальна статистика проєкту
├── Documents          → всі завантажені документи
├── Media Forensics    → forensic аналізи зображень (EXIF, ELA, C2PA)
├── Claims             → витягнуті твердження + статуси верифікації
├── Contradictions     → виявлені суперечності між документами
├── Credibility        → оцінки достовірності джерел
├── ACH                → матриці конкуруючих гіпотез
├── Search             → семантичний/keyword/hybrid пошук
├── Summary            → авто-резюме документів
├── Entities           → витягнуті сутності (особи, організації)
├── Timeline           → хронологічний перегляд подій
├── Export / Reports   → PDF/DOCX/JSON звіти
└── Settings           → LLM, API ключі, workers
Слайд 72 — Інтеграція SHATTERED з зовнішніми інструментами
SHATTERED не замінює — він інтегрує:
| Зовнішній інструмент | Роль | Як пов’язати з SHATTERED |
|---|---|---|
| TinEye | Зворотний пошук | API ключ → автоматичні результати у Media Forensics |
| Google Vision | Виявлення об’єктів + пошук | API ключ → авто-пошук |
| Wayback Machine | Архів сторінок | Завантаж архівну копію → /api/ingest/upload |
| Telegram Export | Збір даних | Експортуй JSON → /api/ingest/ingest-path |
| Maltego | Граф зв’язків | Експортуй Entities з SHATTERED → імпортуй |
| Botometer | Бот-детекція Twitter | Копіюй результат → додай як документ → Claims |
REST API-перша архітектура: будь-який зовнішній скрипт може надсилати дані у SHATTERED через HTTP.
Слайд 75 — Обмеження SHATTERED і що робити
| Обмеження | Ситуація | Рішення |
|---|---|---|
| Без LLM Claims і ACH не працюють повністю | Немає API ключа | LM Studio + Llama 3.1 8B (безкоштовно, локально) |
| ELA не завжди однозначна | Foto без монтажу але яскраві зони | Комбінуй з EXIF і reverse search |
| C2PA тільки для нових камер/Adobe | Старе фото | C2PA absence ≠ фейк |
| Reverse search без API = ручні URL | Немає SERPAPI | SHATTERED генерує URL → клікаєш вручну |
| Мова: англійська краща для NER | Ukrainомовний текст | Встанови uk_core_news_sm або перекладай через LLM перед аналізом |
Offline mode (для чутливих розслідувань):
# .env
ARKHAM_OFFLINE_MODE=true
# → відключає всі зовнішні API запити
# → reverse search = тільки локальні URL посилання
Слайд 76 — Чеклист верифікації з SHATTERED
□ Проєкт створено в SHATTERED
□ Документи/зображення/відео завантажені

MEDIA FORENSICS (зображення)
□ POST /media-forensics/analyze {"document_id": "..."} запущено
□ EXIF flags перевірено (GPS, дата, ПЗ, C2PA — всі в одному аналізі)
□ ELA: POST /media-forensics/ela {"analysis_id": "..."} виконано
□ Sun position перевірено (якщо є GPS)
□ Reverse search: POST /media-forensics/similar {"analysis_id": "...", "search_type": "both"}
□ AI Junior Analyst запущено (якщо є підозри)

CLAIMS (текст)
□ POST /claims/extract-from-document/{doc_id} виконано (або /claims/extract з текстом)
□ Кожне твердження статус призначений
□ Докази прив'язані до key claims

CONTRADICTIONS (кілька документів)
□ /contradictions/analyze для всіх пар
□ Critical/High суперечності розслідувані
□ Статуси оновлені (confirmed/dismissed)

CREDIBILITY (джерело)
□ /credibility/assessments створено
□ MOM/POP/MOSES/EVE чеклист заповнено
□ Рівень: unreliable / low / medium / high / verified

ACH (гіпотези)
□ POST /ach/matrix → matrix_id
□ POST /ach/hypothesis (×N) → H1, H2, H3...
□ POST /ach/evidence (×M) → E1, E2...
□ PUT /ach/rating (×N×M) → рейтинги виставлено
□ POST /ach/score?matrix_id=... → бали розраховано
□ POST /ach/ai/insights → leading hypothesis визначено
□ POST /ach/ai/premortem → failure modes перевірено
□ POST /ach/ai/devils-advocate → blind spots перевірено

ФІНАЛ
□ Рейтинг A/B/C/D визначено
□ Звіт /api/reports або /api/export
□ Provenance chain збережено
Слайд 80 — Типові помилки при роботі з SHATTERED
| Помилка | Симптом | Рішення |
|---|---|---|
| LLM не налаштований | Claims extraction порожня | Перевір LLM_ENDPOINT у .env |
| Workers не запущені | Jobs застрягли у “pending” | python -m arkham_frame.workers.cli --tier recommended |
| pgvector не встановлений | Semantic search не працює | CREATE EXTENSION vector; у PostgreSQL |
| Файл > 50MB | Upload 413 error | Налаштуй MAX_FILE_SIZE або стисни файл |
| spaCy не встановлений | NER entities порожні | python -m spacy download en_core_web_sm |
| Тільки Docker але немає GPU | OCR повільний | Використовуй paddle_only mode або Cloud VLM |
| ACH score все нулі | Рейтинги не виставлені | PUT /ach/rating для кожної пари evidence×hypothesis, потім POST /ach/score |
| ELA повертає 503 | Pillow не встановлений | pip install Pillow в середовищі frame |
C2PA signature_valid: false | Немає trust anchors | Встанови MEDIA_FORENSICS_TRUST_ANCHORS_PATH або ігноруй (manifest parsing все одно працює) |
Швидка діагностика:
# Стан всіх шардів
curl http://localhost:8100/api/shards | jq '.[].status'

# Помилки в queue
curl http://localhost:8100/api/ingest/queue | jq '.failed'

# Логи
docker compose logs -f app | grep ERROR
Слайд 81 — Підсумок: SHATTERED у верифікаційному pipeline
10 ключових тезисів:
- SHATTERED — єдина платформа де media forensics, claims, contradictions, credibility і ACH пов’язані між собою
- Media Forensics: EXIF + ELA + GPS + C2PA + Sun position в одному ендпоінті
- Claims: формалізований трекінг кожного твердження з доказами і статусами
- Contradictions: автоматичний пошук конфліктів між документами через embeddings + LLM
- Credibility MOM/POP/MOSES/EVE: інтелідженс-стандарт реалізований як API
- ACH: структурований метод замість підтвердження однієї гіпотези
- Provenance: аудит-траса кожного висновку — юридично і журналістськи надійно
- EventBus: шарди реагують на події одне одного (media → claims → contradictions)
- Offline mode: для чутливих розслідувань без зовнішніх API
- REST API: будь-який скрипт або інструмент може надсилати дані у SHATTERED
Домашнє завдання → ДЗ-03
Матеріали → Матеріали-Урок-03-Верифікація
← Урок-02-GenAI-для-аналітика | Урок-04-Соцмережі-та-медіапростір →